系统知识点回顾
1,文件管理服务
1.1,文件上传全过程
content-type:multipart/form-data
1.2,大文件上传
分片(spark-md5唯一性)、上传、合并
md5的碰撞性
1.3,零拷贝技术
| 技术名称 | DMA拷贝次数 | CPU拷贝次数 | 上下文切换次数 | 实现原理 | 应用实例 |
|---|---|---|---|---|---|
| 传统方式 read+write |
2 | 2 | 4 | 1️⃣用户态read,切换到内核态 2️⃣DMA拷贝磁盘到内核缓冲区 3️⃣CPU拷贝内核缓冲区到用户缓冲区 4️⃣切换用户态,操作文件 4️⃣用户write,切换内核态 5️⃣CPU拷贝用户缓冲区到内核缓冲区 6️⃣DMA拷贝socket缓冲区到网卡 7️⃣切换用户态 |
|
| 用户态直接IO | 0 | 2 | 0 | 1️⃣用户态read,切换内核态 2️⃣CPU拷贝(异步io)磁盘缓冲区到用户缓冲区 3️⃣切换用户态操作 4️⃣用户态write,切换内核态 5️⃣CPU拷贝用户缓冲区到网卡 |
数据库 DPDK |
| mmap+write | 2 | 1 | 4 | 用户态mmap、write函数操作 内核中读缓冲区(read buffer)的地址 与用户空间的缓冲区(user buffer)进行映射 |
RocketMQ KafkaProvider |
| sendfile | 2 | 1 | 2 | 存粹的透传,用户态sendfile 有一次CPU拷贝内核缓冲区到socket缓冲区 |
典型的消息队列存取 |
| sendfile DMA gather copy |
2 | 0 | 2 | 存粹的透传,用户态sendfile 网卡直接引用内核read缓冲区 |
KafkaConsumer 多个消费者,复用内核缓冲区 |
| Splice | 2 | 0 | 2 | 存粹的透传,用户态splice函数 内核空间的读缓冲区(read buffer)和网络缓冲区(socket buffer)之间建立管道(pipeline) |
1.4,MinIO技术细节
2,高可用
2.1,防系统雪崩架构
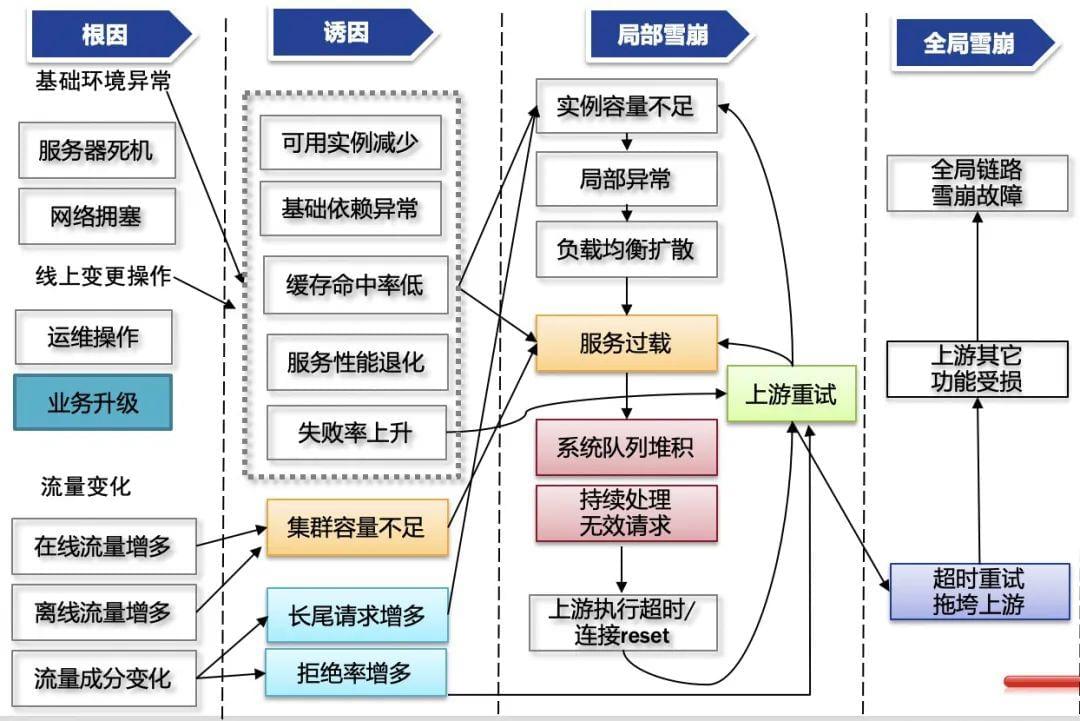
预防:
通过各种手段,规避雪崩初始阶段的出现,例如热点治理、长尾治理、分级操作、容量保障等。
阻止:
处于雪崩初始阶段,有发生雪崩的可能性,需要阻止雪崩进入循环阶段。
重试率控制、队列控制、限流
止损:
通过各种手段,加速雪崩止损恢复,例如:
- 限流:通过多次人工调整限流阈值,使后端请求减少,逐渐恢复;
- 重启服务:通过重启服务,快速丢弃系统队列中的无效请求。
总结:
一旦处于雪崩状态,是不可逆的,需要比较长的时间去恢复。
所以重点在于预防和阻止,因为预防会有遗漏,更多的精力在于阻止,即处于雪崩初始阶段,有发生雪崩的可能性,需要阻止雪崩进入循环阶段。
业界的做法,其实可以分成两种做法:
- 减少过载流量:比如限流和重试率控制,剔除服务不能够承载的流量;
- 减少无效请求:比如队列控制,使得服务处理有效的流量。
这两种做法需要结合,单个做法是会有问题的。
- 减少过载流量:基于动态熔断,根据下游请求成功率动态限制转发请求数,借鉴网络拥塞原理,但无法解决 DDoS 攻击;流量隔离适用于高低优流量场景,通过分级和部署隔离实现。
- 减少无效请求:基于请求有效性,结合绝对时间和相对时间,借助 UFC 解决机器时钟不一致和队列等待时间问题;基于 socket 有效性,通过判断 socket 读到 fin 包事件,在不同语言和框架中判断客户端是否断开连接
减少过载流量-基于动态熔断
减少过载流量-基于流量隔离
减少无效请求-基于请求有效性(19年的技术)
减少无效请求-基于socket有效性
2.2,共识一致性算法
| 算法名称 | 原理 | 应用实践 |
|---|---|---|
| Quorum | 弱一致性算法,写入事务效率高;读大多数最新版本 | Cassandra、ZooKeeper、Chubby、Ceph |
| Paxos | 基于消息传递且具有高度容错特性的一致性算法 cluster多副本架构 |
MySQL 5.4 |
| Raft | 候选人、领导人、跟随者 一主多从架构,term任期的概念,半数以上提交 |
Etcd、consul、RocketMQ、RedisSentinel、TiDB |
| Zab | Zookeeper Atomic Broadcast原子广播 ZXID(epoch\counter\SID) |
zookeeper、kafka |
| KRaft | Kafka 集群的控制器(Controller)节点通过 Raft 协议选举出一个领导者,负责管理集群的元数据和状态变更。 Kafka 引入了支持多版本并发控制(MVCC)的 Timeline 数据结构,包括 TimelineHashMap、TimelineHashSet、TimelineInteger、TimelineLong 等。这些数据结构通过 SnapshotRegistry 管理,允许在领导者切换时,将内存状态回滚到上一个已被 KRaft 多数派确认的状态,避免脏数据的产生。 |
最新的kafka一致性算法 |
WARO协议
是一种简单的副本控制协议,当 Client 请求向某副本写数据时(更新数据),只有当所有的副本都更新成功之后,这次写操作才算成功,否则视为失败。这样的话,只需要读任何一个副本上的数据即可。但是WARO带来的影响是写服务的可用性较低,因为只要有一个副本更新失败,此次写操作就视为失败了。
到这里,再来看Quorum机制到底是个什么鬼?他比WARO又好在什么地方
Quorum机制(法定人数机制)
Quorum 的定义如下:假设有 N 个副本,更新操作 wi 在 W 个副本中更新成功之后,则认为此次更新操作 wi 成功,把这次成功提交的更新操作对应的数据叫做:“成功提交的数据”。对于读操作而言,至少需要读 R 个副本,其中,W+R>N ,即 W 和 R 有重叠,一般,W+R=N+1。
ZAB(Zookeeper Atomic Broadcast)算法原理
2.3,CAP 理论
CAP 三要素定义:
- 一致性(consistent):所有节点在同一时刻看到相同的数据(强一致性)。
- 可用性(Available):非故障节点在合理时间内返回合理响应(无超时、无错误)。
- 分区容错性(Partition tolerance):网络分区(如节点间通信中断)时,系统仍能继续运行。

微服务的 “必然 P”:
微服务通过网络通信协作,网络分区(如超时、丢包、防火墙隔离)是常态,因此P 是必须接受的前提,实际设计中只能在 C 和 A 之间取舍,形成两种典型架构模式:- CP(一致性 + 分区容错性):牺牲部分可用性,确保数据强一致(如服务注册中心 Consul)。
- AP(可用性 + 分区容错性):牺牲强一致性,保证服务可用(如服务注册中心 Eureka)。
3.微服务中 CAP 的典型应用场景
服务注册与发现(核心基础设施)
| 组件 | CAP 选择 | 设计逻辑 | 典型实现 |
|---|---|---|---|
| Consul | CP | 优先保证服务列表的一致性,网络分区时拒绝返回过时数据(可能导致服务不可用)。 | 使用 Raft 协议实现强一致存储,适合对服务列表准确性要求高的场景(如金融)。 |
| Eureka | AP | 优先保证可用性,允许节点在分区时保留本地缓存的服务列表(可能包含过时数据)。 | 去中心化架构,节点间异步复制,适合高可用但允许最终一致的互联网场景。 |
| ZooKeeper | CP | 通过 Quorum 机制保证注册数据强一致,分区时非 Leader 节点不可写(短暂不可用)。 | 适用于分布式协调(如分布式锁),但对微服务注册来说可用性略低。 |
2.4,BASE理论
Basically Available(基本可用)、Soft-state(软状态)、Eventually Consistent(最终一致性) 三个短语的缩写。BASE 理论是对 CAP 中一致性 C 和可用性 A 权衡的结果,其来源于对大规模互联网系统分布式实践的总结,是基于 CAP 定理逐步演化而来的,它大大降低了我们对系统的要求。

基本可用
基本可用是指分布式系统在出现不可预知故障的时候,允许损失部分可用性。但是,这绝不等价于系统不可用。
什么叫允许损失部分可用性呢?
- 响应时间上的损失: 正常情况下,处理用户请求需要 0.5s 返回结果,但是由于系统出现故障,处理用户请求的时间变为 3 s。
- 系统功能上的损失:正常情况下,用户可以使用系统的全部功能,但是由于系统访问量突然剧增,系统的部分非核心功能无法使用。
软状态
软状态指允许系统中的数据存在中间状态(CAP 理论中的数据不一致),并认为该中间状态的存在不会影响系统的整体可用性,即允许系统在不同节点的数据副本之间进行数据同步的过程存在延时。
最终一致性
最终一致性强调的是系统中所有的数据副本,在经过一段时间的同步后,最终能够达到一个一致的状态。因此,最终一致性的本质是需要系统保证最终数据能够达到一致,而不需要实时保证系统数据的强一致性。
2.5,分布式一致性
- 强一致性:系统写入了什么,读出来的就是什么。
- 弱一致性:不一定可以读取到最新写入的值,也不保证多少时间之后读取到的数据是最新的,只是会尽量保证某个时刻达到数据一致的状态。
- 最终一致性:弱一致性的升级版,系统会保证在一定时间内达到数据一致的状态。
业界比较推崇是最终一致性级别,但是某些对数据一致要求十分严格的场景比如银行转账还是要保证强一致性。
- 读时修复 : 在读取数据时,检测数据的不一致,进行修复。比如 Cassandra 的 Read Repair 实现,具体来说,在向 Cassandra 系统查询数据的时候,如果检测到不同节点的副本数据不一致,系统就自动修复数据。
- 写时修复 : 在写入数据,检测数据的不一致时,进行修复。比如 Cassandra 的 Hinted Handoff 实现。具体来说,Cassandra 集群的节点之间远程写数据的时候,如果写失败 就将数据缓存下来,然后定时重传,修复数据的不一致性。
- 异步修复 : 这个是最常用的方式,通过定时对账检测副本数据的一致性,并修复。
比较推荐 写时修复,这种方式对性能消耗比较低。
2.6,分布式事务
| 名称 | 亮点 | 应用 |
|---|---|---|
| 2PC | 一(准备CanCommit)阶段、二(提交DoCommit)阶段 性能、可靠性、数据一致性、二阶段无法提交等问题 |
|
| 3PC | 超时机制、CanCommit、DoCommit中间插入准备(PreCommit)阶段 与2PC相比,3PC降低了阻塞范围 |
比较适合传统的单体应用,在同一个方法中存在跨库操作的情况,不适合高并发和高性能要求的场景。 |
| TCC | 针对每个操作,都要实现对应的确认和补偿操作 业务逻辑的每个分支都需要实现 try、confirm、cancel 三个操作 允许空回滚、防悬挂控制、幂等控制 |
适用于执行时间确定且较短,实时性要求高,对数据一致性要求高 互联网金融企业最核心的三个服务:交易、支付、账务 |
| Saga | 将长事务拆分为多个本地短事务并依次正常提交,如果所有短事务均执行成功,那么分布式事务提交; 如果出现某个参与者执行本地事务失败,则由 Saga 事务协调器协调根据相反顺序调用补偿操作,回滚已提交的参与者,使分布式事务回到最初始的状态 向后恢复(撤销)、向前恢复(必须要成功) 命令协调、事件编排 |
Saga 事务较适用于补偿动作容易处理的场景 |
| 本地事务表 | 将分布式事务拆分成本地事务进行处理,在该方案中主要有两种角色:事务主动方和事务被动方 事务主动发起方需要额外新建事务消息表,并在本地事务中完成业务处理和记录事务消息, 并轮询事务消息表的数据发送事务消息,事务被动方基于消息中间件消费事务消息表中的事务。 |
hik租户清理业务逻辑 适用于事务中参与方支持操作幂等,对一致性要求不高,业务上能容忍数据不一致到一个人工检查周期,事务涉及的参与方、参与环节较少,业务上有对账/校验系统兜底。 |
| MQ事务消息 | 本质上是对本地消息表的封装 | |
| 最大努力通知 | 最大努力通知也称为定期校对,是对MQ事务方案的进一步优化 |
hik的租户相关的业务逻辑采用的是本地事务表+rabbitMQ的形式实现的
管控中心:
创建租户(比较简单)
删除租户(比较麻烦)命令协调型
1️⃣数据源资源;2️⃣库表权限管理;3️⃣审批管理;4️⃣租户数据;
事务分等级,库表权限是必须要处理的


七种常见分布式事务详解(2PC、3PC、TCC、Saga、本地事务表、MQ事务消息、最大努力通知)
2.7,分布式锁
- MySQL
- zookeeper
- Etcd
- Chubby
- redis
1,黄铜方案(加锁解锁)
opsForValue().setIfAbsent(“lock”, “123”);
设想一种家庭场景:晚上小空一个人开锁进入了房间,打开了电灯💡,然后突然断电了,小空想开门出去,但是找不到门锁位置,那小明就进不去了,外面的人也进不来。
缺点:无超时时间
2,白银方案(超时释放锁),被另外一个人抢到锁
expire(“lock”, 10, TimeUnit.SECONDS);
白银方案看似解决了线程异常或服务器宕机造成的锁未释放的问题,但还是存在其他问题:
因为占锁和设置过期时间是分两步执行的,所以如果在这两步之间发生了异常,则锁的过期时间根本就没有设置成功。(加锁与设置过期时间的原子性)
所以和青铜方案有一样的问题:锁永远不能过期。
3,黄金方案(加锁与设置过期时间的原子性)
setIfAbsent(“lock”, “123”, 10, TimeUnit.SECONDS);
缺点:A加锁但是处理时间很久,超时释放了锁,B加锁进行处理,A处理完成释放掉B的锁
4,铂金方案(给每个锁设置不同的编号,只能释放自己的锁)
setIfAbsent(“lock”, uuid, 10, TimeUnit.SECONDS);
缺点:查询锁和删除锁两个操作不是原子性,拿到的确实是自己的锁,但是删除的却是别人的锁
5,钻石方案(查询与删除锁使用lua脚本实现原子性)
1 | if redis.call("get",KEYS[1]) == ARGV[1] |
6,续期问题
A在获取到锁后,正常处理中如何续期
为了解决锁过期问题,需要在锁持有期间动态延长锁的有效期(续期)。常见方法是:
- 后台线程定时检查并续期:在获取锁后,启动一个守护线程或定时任务,定期检查锁是否仍由当前线程持有,若是则延长过期时间。
- 客户端库自动续期:使用支持续期的分布式锁客户端(如Redisson),自动处理续期逻辑。
解决方案1:手动实现锁续期
实现步骤
1,获取锁时记录唯一标识:
- 使用UUID或线程ID作为锁的value,确保只有锁的持有者能续期或释放。
2,启动续期线程:
- 在获取锁成功后,启动一个后台线程,每隔一定时间(例如过期时间的1/3)检查锁状态并续期。
3,续期逻辑:
- 检查Redis中key的value是否仍为当前线程的标识,若是则调用
PEXPIRE延长过期时间。
4,释放锁时停止续期:
- 任务完成后释放锁,同时终止续期线程。
解决方案2:使用Redisson自动续期(本质就是1方案)
Redisson是一个强大的Redis客户端,内置了对分布式锁的支持,包括自动续期功能(Watchdog机制)。
Watchdog机制
- Redisson会在锁获取成功后启动一个后台任务(默认每10秒检查一次)。
- 若线程仍持有锁,则自动调用
PEXPIRE将过期时间延长至30秒。 - 锁释放后,续期任务自动停止。
2.8,undo、Redo
| 特性 | undo 日志 | redo 日志 |
|---|---|---|
| 目标 | 撤销未提交操作,保证原子性 | 重做已提交操作,保证持久性和一致性 |
| 日志内容 | 旧值(Before Image) | 新值(After Image) |
| 执行顺序 | 逆序(后记录先执行) | 顺序(先记录先执行) |
| 幂等性 | 非幂等(回滚操作依赖状态) | 幂等(重复执行不改变结果) |
| 典型场景 | 事务回滚、故障后清除未提交操作 | 持久化恢复、日志复制、共识同步 |
3,基础
3.1,锁的类型
- 互斥锁(Mutex):(synchronized、ReentrantLock)
- 互斥锁是最常见的锁类型,用于保护临界区,确保同一时间只有一个线程可以访问某个资源。
- 当一个线程尝试获取已经被其他线程持有的互斥锁时,它会被阻塞,直到锁被释放。
- 条件变量(Condition Variable):(Lock+Condition)
- 条件变量通常与互斥锁一起使用,允许线程等待某个条件成立。
- 当条件不满足时,线程会阻塞在条件变量上,释放互斥锁,允许其他线程修改条件。
- 当条件成立时,一个或多个等待的线程会被唤醒,并重新尝试获取互斥锁。
- 自旋锁(SpinLock):(unsafe.compareAndSwapInt)
- 当线程尝试获取自旋锁时,如果锁已经被其他线程持有,该线程会忙等待(即循环检查锁是否可用),而不是被阻塞。
- 自旋锁适用于锁持有时间很短的情况,避免线程上下文切换的开销。但如果锁持有时间较长,忙等待会浪费CPU资源。
- 信号量(Semaphore):(Semaphore)
- 信号量是一个计数器,用于控制对多个资源的访问。
- 它允许多个线程或进程同时访问资源,但总数不能超过信号量的初始值。
- 信号量可以用于实现互斥锁、读写锁等功能,也可以用于限制对有限资源的并发访问。
- 读写锁(ReadWriteLock):(ReentrantReadWriteLock)
- 读写锁允许多个线程同时读取共享资源,但只允许一个线程写入。
- 这对于读操作远多于写操作的场景非常有用,可以提高并发性能。
- 乐观锁(Optimistic Locking):( @Version)
- 乐观锁假设多个线程或进程在并发访问共享资源时不会经常发生冲突。
- 它通常通过版本号或时间戳来实现,每次读取数据时都会获取一个版本号,在写回数据时检查版本号是否发生变化。
- 如果版本号未变,则写回数据;如果版本号已变,则说明有其他线程修改过数据,需要重新读取。
- 悲观锁(Pessimistic Locking):(@Lock(LockModeType.PESSIMISTIC_WRITE))
- 与乐观锁相反,悲观锁假设并发访问共享资源时冲突是常态。
- 因此,在访问数据之前,它会先获取锁,确保在数据处理期间其他线程无法修改数据。
- 这可能导致更多的线程阻塞和上下文切换,但在某些场景下可能是必要的。
管程模型设计,管程是解决并发编程问题的一个通用模型
公平锁和非公平锁的区别在于,公平锁的场景线程在进行加锁的时候,首先会看有没有人排队,有人排队的话那么自己就乖乖到队伍里排队,没有人排队的话才去加锁,而非公平锁则是上来就直接加锁,不管你有没有人排队,类似于现实生活中的排队与插队的区别。
可重入锁为是否允许同一个线程多次获得同一把锁的情况
4,基础设施
4.1,数据库(Postgres)
索引B+树、唯一主键、MVCC、数据同步
4.2,缓存(Redis)
- RDB、AOF
- 数据类型
- 主从、哨兵模式、cluster模式
- 缓存击穿(打到数据库)、缓存穿透(null)、雪崩(大量失效)
- 布隆过滤器、布隆计数器
4.3,消息中间件(Kafka)
4.4,消息中间件(RabbitMQ)
4.5,网关(nginx)
4.5,数据库(ClickHouse)
4.4,数据库(Cassandra)
4.5,数据库(Prometheus)
5,集群运维
5.1,Docker容器化
5.2,K8s集群
5.3,CICD
5.4,服务网格(istio)